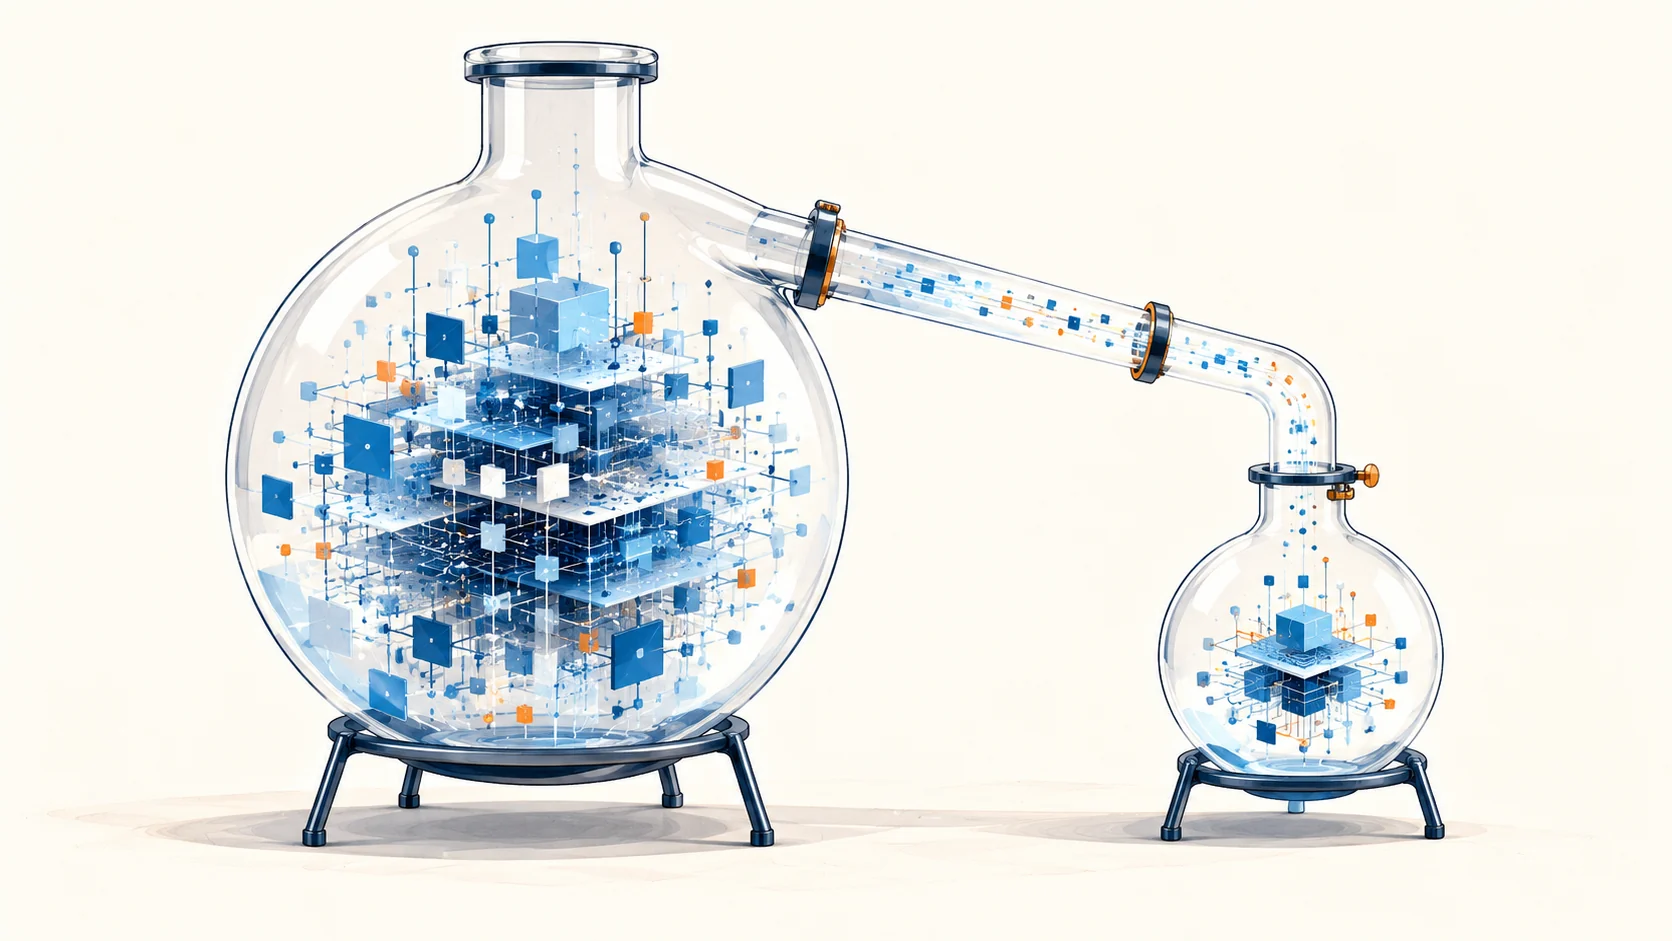
Dans mon article sur le Model Collapse, je revenais sur une idée que l’on entend régulièrement : à force d’entraîner des intelligences artificielles sur des contenus produits par d’autres IA, les modèles finiraient nécessairement par se dégrader. Le raisonnement semble logique. Si une photocopie sert à produire la suivante, puis la suivante, on imagine assez facilement l’image perdre progressivement en qualité. Sauf que les laboratoires ne récupèrent pas simplement au hasard du contenu généré par IA sur Internet pour le réinjecter dans leurs modèles. Ils peuvent aussi utiliser leurs modèles les plus puissants pour fabriquer volontairement des données destinées à en entraîner d’autres.
Et c’est là que la question devient, à mon sens, beaucoup plus intéressante. Car il existe un paradoxe assez contre-intuitif : dans certaines tâches, un modèle beaucoup plus petit peut parvenir à égaler, voire dépasser, un modèle plus puissant. À première vue, cela semble presque absurde. Si un modèle possède moins de capacité, moins de ressources et qu’une partie de son apprentissage provient justement d’un modèle supérieur, comment pourrait-il finir par faire mieux que celui qui lui a appris ? La réponse tient en partie dans une technique appelée distillation. Mais surtout, elle oblige à préciser ce que nous voulons dire lorsque nous affirmons qu’un modèle est « meilleur » qu’un autre.
1. Pourquoi fabriquer un modèle plus petit si le gros existe déjà ?
C’est probablement la première question à se poser. Si nous disposons déjà d’un modèle extrêmement puissant, pourquoi en construire un autre qui, sur le papier, possède moins de capacités ? Tout simplement parce que la puissance a un coût. Un modèle frontière est conçu pour résoudre une immense variété de problèmes : écrire du code, analyser un texte, traduire, résumer, raisonner sur des données ou encore utiliser des outils. Cette polyvalence est évidemment très intéressante, mais elle signifie aussi que nous mobilisons une énorme quantité de capacités dont nous n’avons pas forcément besoin pour chaque tâche.
Si je veux simplement classer quelques milliers de demandes clients dans cinq catégories, ai-je réellement besoin de faire intervenir le modèle le plus puissant disponible à chaque fois ? Probablement pas. C’est un peu comme demander à un professeur d’université de venir vérifier chaque multiplication d’une classe de primaire. Il saura évidemment le faire. Le problème n’est pas sa compétence, mais la disproportion entre ses capacités et la tâche qu’on lui demande de résoudre. Or cette disproportion finit par compter lorsque le modèle est appelé des milliers ou des millions de fois : temps de réponse, coût et ressources de calcul deviennent alors des contraintes très concrètes.
C’est précisément l’un des objectifs de la distillation telle que la présente OpenAI : utiliser les sorties d’un modèle très performant pour améliorer un modèle plus économique, afin que ce dernier puisse se rapprocher de ses performances sur des tâches spécifiques. La question devient donc assez naturelle : peut-on utiliser le gros modèle pour transmettre une partie de ses capacités, plutôt que d’avoir besoin de lui à chaque requête ?
2. La distillation : le professeur ne transmet pas son cerveau, il fabrique le cours
L’image du professeur et de l’élève est assez pratique pour comprendre le mécanisme, à condition de ne pas la prendre trop littéralement. Le professeur est le modèle le plus puissant. On lui soumet un grand nombre de problèmes correspondant à la tâche qui nous intéresse et on récupère ses réponses. Ces sorties peuvent ensuite servir à constituer un jeu de données destiné à entraîner un modèle plus petit. Autrement dit, le petit modèle n’ouvre pas le cerveau du grand pour copier ses connexions internes : il apprend à partir de ce que le grand modèle produit.
OpenAI décrit par exemple son processus de distillation comme un enchaînement entre génération de réponses avec un modèle frontière, constitution d’un jeu de données, fine-tuning d’un modèle moins coûteux puis évaluation des résultats. Et le processus est itératif : si le petit modèle reste mauvais dans certains cas, on peut identifier ces erreurs, produire de meilleurs exemples et recommencer l’entraînement. Dès lors, nous sommes assez loin de l’image simpliste d’une IA qui apprendrait indistinctement sur « du contenu d’IA ». Le professeur peut être sollicité précisément pour fabriquer les données dont l’élève a besoin.
Prenons un exemple volontairement simple dans un domaine que je connais bien. Supposons que je veuille entraîner un petit modèle à identifier correctement l’intention derrière des requêtes Google Ads. Je peux demander à un modèle beaucoup plus puissant d’analyser des milliers de requêtes, de les classer, de traiter les cas ambigus et de produire des exemples supplémentaires là où mon jeu de données manque de variété. Toutefois, je ne suis pas obligé de tout conserver : je peux évaluer ces réponses, retirer les mauvaises, renforcer certaines catégories, ajouter les cas sur lesquels mon petit modèle échoue, puis l’entraîner à nouveau. Par conséquent, la donnée est bien synthétique puisqu’elle a été produite par une IA, mais elle n’a rien à voir avec une collecte aléatoire de contenus artificiels trouvés sur Internet.
Et c’est précisément le pont avec mon article sur le Model Collapse : le problème n’est pas simplement de savoir si une donnée a été produite par un humain ou par une IA. Ce qui compte aussi est sa qualité, la manière dont elle a été produite et ce que l’on en fait ensuite. Toutefois, à ce stade, nous n’avons pas encore résolu le paradoxe initial. La distillation explique assez bien comment un petit modèle peut récupérer une partie des capacités d’un grand. Elle n’explique pas encore pourquoi il pourrait parfois faire mieux que lui.
3. Comment l’élève peut-il devenir meilleur que le professeur ?
À première vue, il y a quelque chose qui ne fonctionne pas dans le raisonnement. Si un petit modèle apprend à partir des réponses produites par un modèle plus puissant, il devrait au mieux réussir à l’imiter. Comment pourrait-il finir par faire mieux que celui qui lui a servi de professeur ? En réalité, la question vient surtout de ce que nous entendons par « meilleur modèle ». Un grand modèle généraliste doit être capable d’écrire, traduire, coder, analyser un document, résoudre des problèmes mathématiques ou encore répondre à des questions scientifiques. Sa force vient justement de cette polyvalence. Toutefois, cela ne signifie pas qu’il soit optimisé au maximum pour chacune de ces tâches prises séparément.
Prenons à nouveau Google Ads. Imaginons que je dispose d’un grand modèle généraliste capable d’analyser correctement une campagne publicitaire, puis d’un modèle beaucoup plus petit que j’entraîne spécifiquement sur des milliers de requêtes, annonces, structures de campagnes, taux de conversion et cas d’erreurs. Le grand modèle restera évidemment beaucoup plus polyvalent. Je pourrai lui demander ensuite de parler de neurosciences ou de philosophie, ce que mon petit modèle spécialisé fera probablement très mal. En revanche, sur le périmètre très précis pour lequel il a été entraîné, le petit modèle peut se rapprocher fortement du grand, voire obtenir de meilleurs résultats sur certains critères d’évaluation.
Dès lors, le paradoxe disparaît en grande partie. L’élève n’est pas devenu globalement plus intelligent que son professeur, il est devenu meilleur sur un exercice particulier qu’il a répété et pour lequel son apprentissage a été optimisé. C’est finalement quelque chose que nous connaissons très bien chez l’humain : un spécialiste peut dépasser quelqu’un possédant une culture beaucoup plus large dès lors que l’on entre précisément dans son domaine d’expertise. Par conséquent, lorsque nous lisons qu’un petit modèle « dépasse » un modèle beaucoup plus gros, la première question devrait toujours être : sur quelle tâche ?
4. Les données synthétiques permettent de fabriquer l’entraînement dont nous avons besoin
Cette idée fait directement le pont avec mon article sur le Model Collapse. J’y expliquais qu’il existe une différence importante entre réentraîner aveuglément une IA sur des contenus artificiels récupérés sur Internet et produire volontairement des données synthétiques dans le but d’entraîner un autre modèle. Dans le premier cas, nous ne maîtrisons ni leur qualité, ni leur origine, ni les erreurs qu’elles peuvent contenir. Dans le second, nous pouvons justement demander au modèle professeur de produire des exemples correspondant à un besoin précis.
Ainsi, si mon petit modèle échoue systématiquement sur une catégorie de requêtes Google Ads ambiguës, je peux utiliser un modèle plus puissant pour créer davantage de cas de ce type. Je peux également lui demander des exemples faciles, difficiles, des contre-exemples ou différentes formulations d’un même problème. Surtout, toutes ces données ne sont pas obligées d’entrer directement dans l’entraînement : elles peuvent être évaluées, filtrées ou supprimées lorsqu’elles sont mauvaises. Le modèle professeur ne se contente donc plus de répondre aux utilisateurs, il devient aussi capable de fabriquer une partie du matériel pédagogique qui permettra d’entraîner les modèles suivants.
C’est pourquoi dire qu’une IA est « entraînée sur des données générées par une autre IA » ne nous apprend finalement pas grand-chose. Ce qui importe est de savoir comment ces données ont été produites, sélectionnées et évaluées. En effet, si le professeur génère une erreur et que celle-ci est ensuite considérée comme une vérité pendant l’entraînement, l’élève peut parfaitement l’apprendre. À l’inverse, si les données sont contrôlées et servent volontairement à couvrir les faiblesses observées du petit modèle, elles peuvent au contraire améliorer son apprentissage. Nous retrouvons ici exactement la nuance que je voulais apporter dans l’article sur le Model Collapse : le problème n’est pas simplement l’origine humaine ou artificielle d’une donnée, mais sa qualité et la manière dont elle est utilisée.
5. Le meilleur modèle n’est donc pas forcément le plus gros
Pendant plusieurs années, l’évolution des modèles d’IA a été assez facile à lire : davantage de paramètres, davantage de données et davantage de puissance de calcul permettaient généralement d’améliorer leurs capacités. Cette logique reste évidemment importante, puisqu’il faut bien développer des modèles suffisamment puissants pour découvrir de nouvelles capacités. Toutefois, la distillation ajoute une seconde étape : une fois qu’un grand modèle sait résoudre certains problèmes, une partie de ces capacités peut ensuite être transmise à des modèles plus petits et beaucoup moins coûteux à utiliser.
Cela change progressivement le rôle du grand modèle. Il n’est plus nécessairement celui que nous allons appeler des millions de fois dans une application. Il peut servir à produire les données, résoudre les problèmes les plus difficiles ou entraîner des modèles spécialisés qui prendront ensuite le relais. Nous nous retrouvons donc avec une sorte de hiérarchie : un modèle très puissant permet de faire émerger de nouvelles capacités, tandis que des modèles plus légers récupèrent ensuite celles qui sont nécessaires à certains usages.
La conséquence est assez importante, car la taille du modèle devient un indicateur de moins en moins suffisant pour choisir celui que nous voulons utiliser. Si un modèle beaucoup plus léger obtient quasiment le même résultat sur la tâche qui m’intéresse, mais répond plus vite et nécessite moins de calcul, le modèle le plus puissant n’est pas nécessairement le plus pertinent. D’autant plus qu’une autre évolution vient encore compliquer cette comparaison : aujourd’hui, le modèle n’est souvent plus utilisé seul.
6. Le modèle n’est qu’une partie du système : le harness
J’avais déjà abordé une partie de cette évolution dans mon article sur les agents d’IA générative. Je séparais alors le modèle de langage, les outils auxquels il pouvait accéder et une couche d’orchestration chargée de coordonner l’ensemble. Le terme de harness, que l’on retrouve de plus en plus aujourd’hui, va finalement dans la même direction : il désigne tout ce que nous construisons autour du modèle pour lui permettre de travailler dans de meilleures conditions.
Concrètement, un modèle peut disposer d’outils pour rechercher une information, exécuter du code ou consulter une base de données. Il peut également recevoir uniquement les éléments de contexte utiles au bon moment, conserver l’état d’une session, travailler avec des fichiers ou déléguer une tâche à d’autres agents. OpenAI décrit aujourd’hui son propre harness agentique comme la couche qui gère notamment le contexte, l’utilisation des outils et la coordination de sous-agents. Dès lors, la performance que nous observons n’est plus uniquement celle du modèle lui-même, mais celle de l’ensemble du système dans lequel il évolue.
Prenons deux modèles. Le premier est beaucoup plus puissant mais reçoit simplement une question et doit produire directement sa réponse. Le second est légèrement moins performant, mais il peut rechercher des informations, ouvrir un fichier, faire un calcul, tester son résultat puis recommencer s’il constate une erreur. Il n’y aurait finalement rien d’étonnant à ce que le second obtienne de meilleurs résultats sur certaines tâches réelles. Pourtant, si nous regardons uniquement leur taille ou un benchmark isolé, nous risquons de tirer la conclusion inverse.
Par conséquent, lorsque nous comparons aujourd’hui deux intelligences artificielles, nous comparons de plus en plus souvent des systèmes et non plus seulement des modèles. La distillation peut améliorer ou spécialiser le modèle, tandis que le harness lui apporte les outils et l’environnement nécessaires pour exploiter correctement ses capacités. C’est aussi la continuité logique de ce que j’écrivais sur les agents : le modèle de langage reste central, mais il devient progressivement une composante d’une architecture beaucoup plus large.
7. Alors, que signifie encore « ce modèle est meilleur » ?
Nous pouvons désormais revenir à la question de départ. Lorsqu’un constructeur annonce qu’un petit modèle égale ou dépasse un modèle beaucoup plus gros, la phrase peut être parfaitement vraie tout en donnant une impression trompeuse. Il faut savoir sur quel benchmark il a été testé, s’il a été spécialisé ou fine-tuné, quels outils lui sont accessibles et, désormais, quel harness l’entoure. Un petit modèle peut être excellent dans un domaine très précis et perdre une grande partie de cet avantage dès que nous sortons de son périmètre.
Ainsi, la distillation ne permet pas de fabriquer magiquement un modèle miniature qui serait supérieur en tout à son professeur. Elle permet plutôt de récupérer certaines capacités d’un grand modèle, puis de les concentrer là où elles sont réellement utiles. Nous échangeons alors une partie de la polyvalence contre de la spécialisation, de la vitesse et une utilisation moins importante des ressources de calcul.
Le meilleur modèle dépend finalement du problème
Ce fonctionnement change finalement la manière dont je regarde l’évolution des modèles d’IA. La course à la taille reste importante, car les modèles les plus puissants continuent d’explorer la frontière de ce qu’il est possible de faire. Cependant, leurs capacités peuvent ensuite se diffuser vers des modèles beaucoup plus petits et spécialisés. Ces derniers peuvent à leur tour être intégrés dans des systèmes qui leur apportent des outils, de la mémoire ou une capacité d’action.
La bonne question n’est donc peut-être plus simplement : quel est le modèle le plus puissant ? Il faut plutôt se demander de quelles capacités nous avons réellement besoin pour résoudre un problème précis et comment les assembler efficacement. La distillation est intéressante pour cette raison : elle montre que le progrès de l’IA ne consiste pas uniquement à construire des modèles toujours plus gros, mais également à apprendre à mieux utiliser et transmettre ce que les plus gros ont déjà appris.